Chương 48: Các ngụy biện thống kê
Câu hỏi mở đầu
Đã biết tương quan không phải nhân quả, vậy mà vẫn bị số liệu đánh lừa. Những cái bẫy nào khiến dữ liệu thật dẫn tới kết luận sai, và làm sao nhận ra chúng?
Phép tính đúng, kết luận sai
Các cái bẫy trong chương này có một điểm chung đáng ngạc nhiên: không cái nào đến từ một phép tính sai. Tỉ lệ được chia đúng, trung bình được cộng đúng, xác suất được tính đúng, vậy mà kết luận rút ra lại sai, đôi khi sai ngược hẳn.
Cấu trúc nguyên thủy đứng sau tất cả là một điều ta đã gặp ở Chương 6: tóm tắt là làm mất thông tin. Một tỉ lệ, một trung bình, một xác suất tính từ dữ liệu đều là những hàm biến cả một bộ dữ liệu thành một con số, và rất nhiều bộ dữ liệu khác nhau cho cùng một con số. Mỗi cái bẫy là một kiểu thông tin đã bị bỏ đi quay lại cắn người đọc: các nhóm khác nhau thế nào (Ví dụ 1), ta đã đặt bao nhiêu câu hỏi (Ví dụ 2), xác suất có điều kiện đi theo chiều nào (Ví dụ 3), con số được so với cái gì (Ví dụ 4), dữ liệu có hình dạng ra sao (Ví dụ 5), điều gì lẽ ra vẫn xảy ra nếu không làm gì (Ví dụ 6), và những dữ liệu nào không lọt được vào mẫu (mục Ranh giới).
Vì sao cấu trúc này phải xuất hiện, dù chưa ai đặt tên cho nó? Vì không thể suy nghĩ về một nghìn con số cùng lúc; ta buộc phải tóm tắt, và một phép tóm tắt không thể giữ lại mọi thứ. Không có con số thống kê nào tự nó sai. Cái sai nằm ở câu hỏi ta tưởng con số ấy trả lời. Cách tự vệ vì thế luôn là một câu hỏi ngược: nếu kết luận của mình sai, thì dữ liệu có thể trông như thế nào, và có khác gì dữ liệu đang có không?
Ký hiệu
Khi xếp \(n\) số theo thứ tự tăng dần, số đứng giữa gọi là trung vị (median); nếu \(n\) chẵn, trung vị là trung bình cộng của hai số đứng giữa. Một nửa dữ liệu nằm không trên trung vị, một nửa nằm không dưới nó.
Nhiều câu hỏi thống kê có dạng: dữ liệu có đủ để bác bỏ khả năng "không có gì xảy ra" không? Khả năng ấy được viết thành một giả thuyết không (null hypothesis), ký hiệu \(H_0\): đồng xu cân đối, thuốc không có tác dụng, hai nhóm như nhau. Giá trị p (p-value) là xác suất, tính với giả định \(H_0\) đúng, để thu được một kết quả ít nhất cực đoan bằng kết quả đã quan sát. Người ta chọn trước một ngưỡng \(\alpha\), gọi là mức ý nghĩa (significance level), thường là \(0{,}05\), và nói kết quả có ý nghĩa thống kê (statistically significant) nếu \(p \leq \alpha\). Khi \(H_0\) đúng mà kết quả vẫn có ý nghĩa thống kê, đó là một ca dương tính giả như ở Chương 43; Mệnh đề 5 cho thấy điều này xảy ra với xác suất không quá \(\alpha\).
Với một biến cố xấu, như mắc một bệnh, xác suất của nó trong một nhóm người gọi là rủi ro tuyệt đối (absolute risk) của nhóm ấy. Tỉ số giữa rủi ro tuyệt đối của hai nhóm gọi là rủi ro tương đối (relative risk). Rủi ro tăng từ \(p_0\) lên \(p_1\) có thể được kể theo hai cách: "tăng \(\frac{p_1}{p_0}\) lần", hay "tăng \(p_1 - p_0\)".
Làm bằng tay
Ví dụ 1 (nghịch lý Simpson: tin kết luận nào?). Hai hãng giao hàng nhận đơn ở nội thành và ngoại thành (số liệu giả định):
| nội thành | ngoại thành | gộp chung | |
|---|---|---|---|
| hãng A | 95 trong 100 (95%) | 240 trong 400 (60%) | 335 trong 500 (67%) |
| hãng B | 360 trong 400 (90%) | 50 trong 100 (50%) | 410 trong 500 (82%) |
Hãng A giao đúng giờ tốt hơn ở cả nội thành lẫn ngoại thành, nhưng tính gộp thì kém hẳn. Chương 10 đã gặp hiện tượng này dưới tên nghịch lý Simpson và giải thích cơ chế: tỉ lệ gộp là trung bình có trọng số của các tỉ lệ riêng, với trọng số là tỉ phần của mỗi nhóm (Mệnh đề 2). Đơn của A có 80% ở ngoại thành, nơi giao khó; đơn của B có 80% ở nội thành. Nếu A nhận đơn với cùng cơ cấu như B, tỉ lệ gộp của A sẽ là \(0{,}8 \cdot 0{,}95 + 0{,}2 \cdot 0{,}6 = 0{,}88\), cao hơn 82% của B.
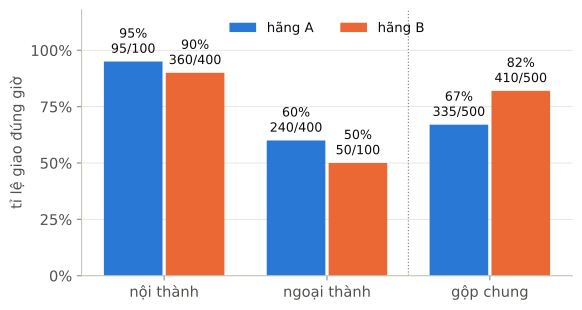
Câu hỏi Chương 10 để ngỏ là: nên tin kết luận nào? Ở đây khu vực ảnh hưởng tới cả việc hãng nào nhận đơn lẫn việc giao có đúng giờ không: nó là một biến gây nhiễu theo nghĩa của Chương 47. Muốn biết hãng nào giao tốt hơn cho một đơn cụ thể, phải so trong cùng khu vực, và A tốt hơn. Nhưng không phải lúc nào tách nhóm cũng đúng; mục Ranh giới sẽ cho một trường hợp tách nhóm lại là sai.
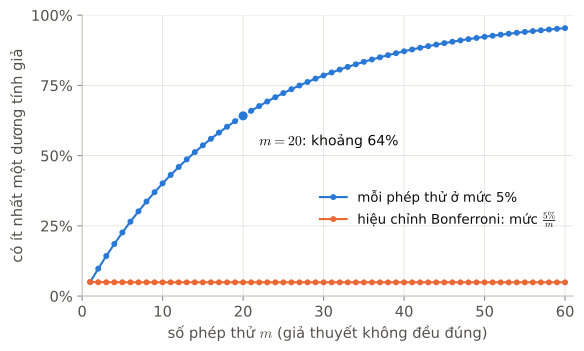
Ví dụ 2 (hai mươi phép thử). Một nhóm nghiên cứu kiểm tra xem 20 loại thực phẩm khác nhau có liên quan tới một bệnh không, mỗi loại một phép thử ở mức ý nghĩa \(0{,}05\). Giả sử thật ra không loại nào liên quan, và các phép thử độc lập. Xác suất để ít nhất một phép thử cho kết quả "có ý nghĩa" là
Gần hai phần ba khả năng sẽ có một "phát hiện" để báo cáo, dù không có gì để phát hiện. Làm nhiều phép thử rồi chỉ báo cáo cái có ý nghĩa gọi là câu cá dữ liệu (data dredging); đây cũng là một cách xảy ra của trùng hợp mà Chương 47 đã nhắc. Cách chữa đơn giản nhất là hiệu chỉnh Bonferroni (Bonferroni correction): khi làm \(m\) phép thử, dùng ngưỡng \(\frac{\alpha}{m}\) cho mỗi phép thử. Với \(m = 20\), ngưỡng là \(0{,}0025\), và xác suất có ít nhất một dương tính giả là \(1 - 0{,}9975^{20} \approx 0{,}049\), dưới 5% (Mệnh đề 3 cho thấy nó không bao giờ vượt 5%, kể cả khi các phép thử không độc lập). Vấn đề nằm ở chỗ đặt nhiều câu hỏi nói chung, gọi là so sánh nhiều lần (multiple comparisons).
Ví dụ 3 (giá trị p, và điều nó không nói). Tung một đồng xu 100 lần được 60 lần ngửa. Với giả thuyết không "đồng xu cân đối", xác suất có từ 60 lần ngửa trở lên là khoảng \(0{,}028\) (Ví dụ 4 của Chương 46); nếu tính cả hai phía, từ 60 lần trở lên hoặc từ 40 lần trở xuống, giá trị p là khoảng \(0{,}057\). Giá trị p là \(P(\text{dữ liệu cực đoan như thế} \mid H_0)\); nó không phải \(P(H_0 \mid \text{dữ liệu})\), xác suất để đồng xu cân đối. Nhầm hai điều này chính là nhầm chiều của xác suất có điều kiện, như ngụy biện công tố viên ở Chương 43. Muốn có \(P(H_0 \mid \text{dữ liệu})\) phải có tiên nghiệm. Giả sử 99% đồng xu trong một túi là cân đối và 1% là đồng lệch, ra ngửa với xác suất \(0{,}6\) (giả định). Tỉ số độ hợp lý của dữ liệu "đúng 60 lần ngửa" là \(\frac{0{,}6^{60} \cdot 0{,}4^{40}}{0{,}5^{100}} = 1{,}2^{60} \cdot 0{,}8^{40} \approx 7{,}5\), nên tỉ lệ cược cho "đồng lệch" là \(7{,}5 : 99\), và xác suất đồng xu là đồng lệch chỉ khoảng 7%. Kết quả "gần có ý nghĩa" ấy vẫn đi với một đồng xu gần như chắc chắn cân đối.
Ví dụ 4 (nguy cơ tăng gấp đôi). Một bản tin viết: "dùng sản phẩm X làm nguy cơ mắc bệnh Y tăng gấp đôi". Giả sử (giả định) rủi ro tuyệt đối tăng từ 1 phần 10.000 lên 2 phần 10.000. Rủi ro tương đối là 2, tức "tăng 100%", nghe đáng sợ. Nhưng rủi ro tuyệt đối chỉ tăng thêm \(\frac{1}{10.000}\), tức \(0{,}01\) điểm phần trăm: cứ 10.000 người dùng thì có thêm một ca bệnh. Cả hai con số đều đúng; bản tin chỉ chọn con số kịch tính hơn. Muốn đánh giá, cần cả hai.
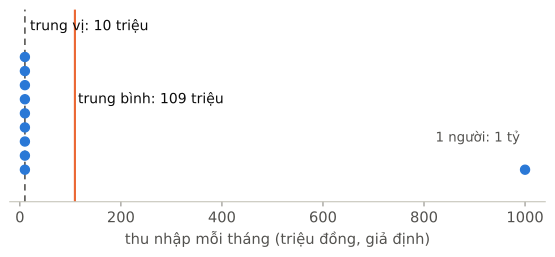
Ví dụ 5 (trung bình và trung vị). Một nhóm 10 người, 9 người có thu nhập 10 triệu đồng mỗi tháng và 1 người có thu nhập 1 tỷ đồng (giả định). Thu nhập trung bình là \(\frac{9 \cdot 10 + 1000}{10} = 109\) triệu, một con số không mô tả được ai trong nhóm; trung vị là 10 triệu. Trung bình là điểm cân bằng của Chương 44, nên một giá trị cực lớn kéo nó đi xa; trung vị chỉ quan tâm thứ tự, nên đứng yên. Với dữ liệu lệch, như thu nhập hay tài sản, "người điển hình" gần trung vị hơn trung bình. Đây cũng là lý do Chương 46 nói về "kết quả ở giữa" của một phân phối lệch.
Ví dụ 6 (hồi quy về giá trị trung bình giả làm tác dụng). Huyết áp tâm thu của những người trong một cộng đồng có trung bình 130 và độ lệch chuẩn 15 (đơn vị mmHg), và hai lần đo cách nhau một tuần có hệ số tương quan \(0{,}5\) (giả định). Một chương trình mời những người có lần đo đầu từ 160 trở lên, tức từ hai độ lệch chuẩn trở lên, tham gia một liệu pháp hoàn toàn vô tác dụng. Tính bằng máy, trung bình lần đo đầu của nhóm này là khoảng \(165{,}6\). Theo đường hồi quy của Chương 47, lần đo sau có trung bình khoảng \(130 + 0{,}5 \cdot (165{,}6 - 130) \approx 147{,}8\). Huyết áp của nhóm "giảm" gần 18 mmHg, và liệu pháp vô tác dụng trông như một thành công. Cách phát hiện: so với một nhóm đối chứng được chọn theo cùng tiêu chí mà không được điều trị; nhóm ấy cũng "giảm" chừng ấy.
Ranh giới
Gộp hay tách tùy cấu trúc nhân quả. Không phải cứ kết luận gộp khác kết luận tách là phải tin kết luận tách. Khi biến chia nhóm là một biến gây nhiễu, như khu vực ở Ví dụ 1, phải tách. Nhưng nếu biến ấy là một mắt xích trên đường từ nguyên nhân tới kết quả, gọi là biến trung gian (mediator), thì tách nhóm theo nó lại xóa mất chính tác dụng muốn đo. Chẳng hạn (giả định) một loại thuốc phòng đột quỵ bằng cách hạ huyết áp: so người uống và không uống thuốc trong từng nhóm có cùng huyết áp sau điều trị, ta so những người mà thuốc đã hoặc chưa làm được việc của nó, và tác dụng của thuốc biến mất khỏi phép so sánh. Cùng một bảng số, câu trả lời đúng phụ thuộc vào sơ đồ nhân quả, thứ không nằm trong bảng.
flowchart LR
  subgraph N1["khu vực là biến gây nhiễu: nên tách"]
    K1["khu vực"] --> H1["hãng nhận đơn"]
    K1 --> D1["đúng giờ"]
    H1 --> D1
  end
  subgraph N2["huyết áp là biến trung gian: không nên tách"]
    T2["uống thuốc"] --> A2["huyết áp sau điều trị"]
    A2 --> Q2["đột quỵ"]
  end
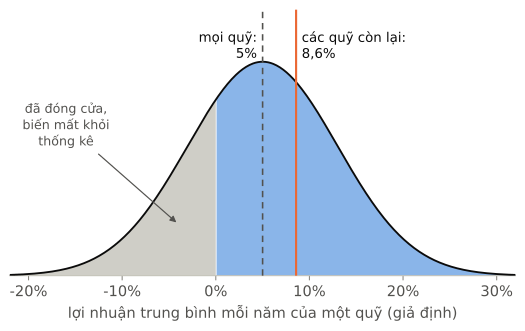
Chỉ nhìn thấy những gì còn lại. Giả sử (giả định) lợi nhuận trung bình mỗi năm của các quỹ đầu tư có phân phối chuẩn với kỳ vọng 5% và độ lệch chuẩn 8%, và mọi quỹ có lợi nhuận trung bình âm đều đóng cửa, biến mất khỏi các bảng xếp hạng. Khoảng 26,6% số quỹ biến mất như thế. Nhìn vào các quỹ còn lại, lợi nhuận trung bình của chúng là khoảng 8,6%, cao hơn hẳn con số 5% của mọi quỹ đã từng tồn tại. Dữ liệu chỉ gồm những gì sống sót thì kể một câu chuyện lạc quan hơn sự thật; đó là thiên lệch sống sót (survivorship bias). Những lời khuyên rút ra từ câu chuyện của người thành công cũng mắc cùng cái bẫy, khi không ai hỏi những người làm y hệt mà thất bại.
Mẫu tự chọn lấy mình. Một trang tin hỏi độc giả của mình "bạn dành bao nhiêu giờ mỗi ngày trên mạng?" và nhận 100.000 câu trả lời (giả định). Con số trung bình thu được mô tả độc giả của trang tin, những người đã đọc tới câu hỏi và chịu trả lời, không mô tả dân số nói chung. Mẫu lớn không chữa được mẫu lệch: như bài A4 của Chương 45 đã nói, điều khó là chọn cho ngẫu nhiên, không phải chọn cho nhiều. Khi cách dữ liệu lọt vào mẫu phụ thuộc vào chính đại lượng cần đo, ta có thiên lệch chọn mẫu (selection bias).
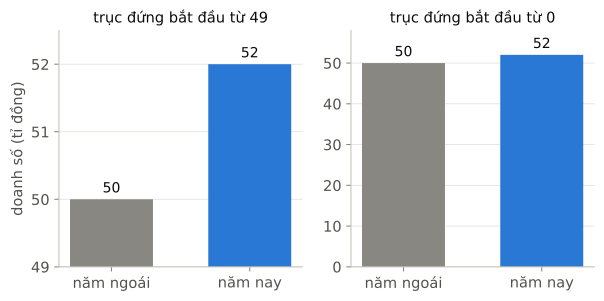
Biểu đồ gây hiểu lầm. Doanh số tăng từ 50 lên 52 tỉ đồng (giả định), tức tăng 4%. Vẽ biểu đồ cột với trục đứng bắt đầu từ 49, cột năm nay cao gấp ba cột năm ngoái. Độ dài của một cột được mắt đọc như độ lớn của con số, nên cắt trục đứng của biểu đồ cột là phóng đại khác biệt. Với biểu đồ đường, trục không bắt đầu từ 0 có thể chấp nhận được, miễn là người đọc được báo rõ.
Ý nghĩa thống kê khác ý nghĩa thực tế. "Có ý nghĩa thống kê" chỉ nói rằng một khác biệt khó giải thích bằng may rủi; nó không nói khác biệt ấy lớn hay đáng quan tâm. Với một triệu người mỗi nhóm, một chế độ ăn làm giảm trung bình \(0{,}1\) kg cân nặng, với độ lệch chuẩn 5 kg, cho độ lệch chuẩn của hiệu hai trung bình khoảng \(0{,}007\) kg, nên hiệu \(0{,}1\) kg cách 0 tới khoảng 14 độ lệch chuẩn (giả định): có ý nghĩa thống kê cực mạnh, mà chẳng có ý nghĩa gì với ai. Ngược lại, một nghiên cứu nhỏ có thể bỏ lỡ một tác dụng lớn thật. Luôn hỏi: khác biệt lớn bao nhiêu, không chỉ: nó có "có ý nghĩa" không.
Phát biểu chặt chẽ
Mệnh đề 1 (nghịch lý Simpson có thể xảy ra). Tồn tại các số dương \(a_1, b_1, a_2, b_2, c_1, d_1, c_2, d_2\) với \(\frac{a_1}{b_1} > \frac{c_1}{d_1}\) và \(\frac{a_2}{b_2} > \frac{c_2}{d_2}\), nhưng \(\frac{a_1 + a_2}{b_1 + b_2} < \frac{c_1 + c_2}{d_1 + d_2}\).
Chứng minh. Bảng ở Ví dụ 1: \(\frac{95}{100} > \frac{360}{400}\), \(\frac{240}{400} > \frac{50}{100}\), nhưng \(\frac{335}{500} < \frac{410}{500}\). \(\square\)
Mệnh đề 2 (tỉ lệ gộp là trung bình có trọng số). Với các số dương, \(\frac{a_1 + a_2}{b_1 + b_2} = w \cdot \frac{a_1}{b_1} + (1 - w) \cdot \frac{a_2}{b_2}\) với \(w = \frac{b_1}{b_1 + b_2}\). Do đó nếu hai bên có cùng cơ cấu nhóm, \(\frac{b_1}{b_1 + b_2} = \frac{d_1}{d_1 + d_2}\), và \(\frac{a_1}{b_1} > \frac{c_1}{d_1}\), \(\frac{a_2}{b_2} > \frac{c_2}{d_2}\), thì \(\frac{a_1 + a_2}{b_1 + b_2} > \frac{c_1 + c_2}{d_1 + d_2}\).
Chứng minh. \(w \cdot \frac{a_1}{b_1} + (1 - w) \cdot \frac{a_2}{b_2} = \frac{a_1}{b_1 + b_2} + \frac{a_2}{b_1 + b_2}\). Nếu hai bên có cùng \(w\), với \(0 < w < 1\), thì \(w \frac{a_1}{b_1} + (1 - w)\frac{a_2}{b_2} > w\frac{c_1}{d_1} + (1 - w)\frac{c_2}{d_2}\), vì mỗi số hạng bên trái lớn hơn số hạng tương ứng bên phải. \(\square\)
Nghịch lý Simpson vì thế chỉ xảy ra khi hai bên có cơ cấu nhóm khác nhau, như 20% và 80% đơn nội thành ở Ví dụ 1.
Mệnh đề 3 (nhiều phép thử). Cho \(m\) phép thử, mỗi phép thử cho dương tính giả với xác suất \(\alpha\) khi giả thuyết không của nó đúng. Nếu mọi giả thuyết không đều đúng và các phép thử độc lập, xác suất có ít nhất một dương tính giả là \(1 - (1 - \alpha)^m\). Không cần độc lập, xác suất ấy không vượt quá \(m\alpha\); vì thế dùng ngưỡng \(\frac{\alpha}{m}\) cho mỗi phép thử thì nó không vượt quá \(\alpha\).
Chứng minh. Gọi \(A_i\) là "phép thử thứ \(i\) cho dương tính giả". Biến cố "không có dương tính giả nào" là giao của các \(\overline{A_i}\), độc lập, mỗi cái có xác suất \(1 - \alpha\), nên có xác suất \((1 - \alpha)^m\); lấy phần bù. Không cần độc lập: \(P(A_1 \cup A_2) \leq P(A_1) + P(A_2)\) (Định lý 2 của Chương 41), và bằng quy nạp (Chương 18), \(P(A_1 \cup \dots \cup A_m) \leq P(A_1) + \dots + P(A_m) = m\alpha\) (bài C2). \(\square\)
Định nghĩa 4 (giá trị p). Cho một giả thuyết không \(H_0\) và một đại lượng \(T\) tính từ dữ liệu, chọn sao cho giá trị càng lớn càng khó xảy ra dưới \(H_0\). Nếu dữ liệu quan sát cho \(T = t\) thì giá trị p là \(p(t) = P(T \geq t \mid H_0)\), xác suất tính trong mô hình của \(H_0\). Với mức ý nghĩa \(\alpha\) chọn trước, kết quả có ý nghĩa thống kê nếu \(p(t) \leq \alpha\).
Mệnh đề 5. Nếu \(H_0\) đúng và \(T\) nhận hữu hạn giá trị, thì xác suất để kết quả có ý nghĩa thống kê không vượt quá \(\alpha\): \(P\big(p(T) \leq \alpha \mid H_0\big) \leq \alpha\).
Chứng minh. Hàm \(t \mapsto p(t) = P(T \geq t \mid H_0)\) không tăng theo \(t\). Nếu không có giá trị \(t\) nào của \(T\) với \(p(t) \leq \alpha\) thì xác suất cần tính bằng 0. Nếu có, gọi \(t^*\) là giá trị nhỏ nhất như thế; vì \(p\) không tăng, \(p(t) \leq \alpha\) khi và chỉ khi \(t \geq t^*\). Vậy \(P\big(p(T) \leq \alpha \mid H_0\big) = P(T \geq t^* \mid H_0) = p(t^*) \leq \alpha\). \(\square\)
Mệnh đề 5 là tất cả những gì giá trị p bảo đảm: một phương pháp dùng ngưỡng \(\alpha\) cho dương tính giả không quá \(\alpha\) số lần giả thuyết không đúng. Nó không nói gì về xác suất để giả thuyết không đúng khi biết dữ liệu; điều đó cần tiên nghiệm, như Ví dụ 3.
Sợi chỉ
- S4. Cục bộ và toàn cục. Nghịch lý Simpson: kết luận trong từng nhóm ngược với kết luận khi gộp, vì tỉ lệ gộp là trung bình có trọng số với trọng số khác nhau cho hai bên (Mệnh đề 2), như ở Chương 10.
- S6. Biểu diễn khác nhau của cùng một cấu trúc. Cùng một bảng số, gộp hay tách cho hai câu chuyện ngược nhau; cùng một mức tăng rủi ro kể thành "gấp đôi" hay "thêm một phần vạn"; cùng một dữ liệu, trung bình và trung vị cho hai "người điển hình" khác nhau. Chọn biểu diễn nào tùy câu hỏi và tùy cấu trúc nhân quả.
- S3. Thứ tự của biến đổi. Giá trị p là \(P(\text{dữ liệu} \mid H_0)\), không phải \(P(H_0 \mid \text{dữ liệu})\); đổi chiều điều kiện là cái bẫy của Chương 43 trong một bộ áo mới.
- S2. Thông tin và khả nghịch. Mọi con số tóm tắt là một hàm nhiều-một từ các bộ dữ liệu; mỗi ngụy biện là một phần thông tin đã mất quay lại làm sai kết luận.
Tóm tắt
- Các ngụy biện thống kê không đến từ phép tính sai mà từ thông tin bị mất khi tóm tắt, và từ việc hỏi sai câu hỏi.
- Nghịch lý Simpson xảy ra khi hai bên có cơ cấu nhóm khác nhau; nên gộp hay tách tùy việc biến chia nhóm là biến gây nhiễu hay biến trung gian.
- Làm nhiều phép thử làm dương tính giả gần như chắc chắn xuất hiện (\(1 - 0{,}95^{20} \approx 64\%\)); hiệu chỉnh Bonferroni dùng ngưỡng \(\frac{\alpha}{m}\).
- Giá trị p là \(P(\text{dữ liệu ít nhất cực đoan như thế} \mid H_0)\), không phải xác suất để \(H_0\) đúng.
- Rủi ro tương đối và rủi ro tuyệt đối kể cùng một thay đổi theo hai cách rất khác nhau; cần cả hai.
- Với dữ liệu lệch, trung vị mô tả "người điển hình" tốt hơn trung bình.
- Thiên lệch sống sót, thiên lệch chọn mẫu, biểu đồ cắt trục và hồi quy về giá trị trung bình đều có thể biến dữ liệu đúng thành kết luận sai; ý nghĩa thống kê không phải ý nghĩa thực tế.
Bài tập
A. Tư duy
A1. Một quảng cáo viết: "9 trong 10 nha sĩ khuyên dùng kem đánh răng của chúng tôi" (giả định). Hãy đặt ba câu hỏi về cách con số này được tạo ra.
Lời giải
Chẳng hạn: những nha sĩ nào được hỏi, và họ được chọn thế nào (thiên lệch chọn mẫu)? Câu hỏi là gì: "có khuyên dùng loại này không", hay "trong các loại sau, loại nào chấp nhận được", nơi một nha sĩ có thể chọn nhiều loại? Đã hỏi bao nhiêu nhóm nha sĩ trước khi có được một nhóm cho con số đẹp (so sánh nhiều lần, chỉ báo cáo kết quả thuận lợi)? Mỗi câu hỏi nhắm vào một phần thông tin mà con số "9 trong 10" đã bỏ đi.
A2. "Những cụ sống thọ nhất trong làng đều uống trà mỗi ngày." Điều này có cho thấy uống trà giúp sống thọ không?
Lời giải
Chưa. Nếu gần như mọi người trong làng đều uống trà mỗi ngày, thì các cụ sống thọ tất nhiên cũng uống trà, cũng như những người mất sớm. Phải so tỉ lệ sống thọ giữa người uống và người không uống, chứ không chỉ nhìn những người sống sót tới tuổi cao. Ngay cả khi tỉ lệ khác nhau, vẫn còn biến gây nhiễu: thói quen uống trà có thể đi cùng một lối sống khác.
A3. Một người đọc kết quả "\(p = 0{,}03\)" và nói: "vậy chỉ có 3% khả năng kết quả này là do may rủi". Câu nói sai ở đâu?
Lời giải
\(0{,}03\) là xác suất thu được dữ liệu ít nhất cực đoan như thế nếu giả thuyết không đúng, tức \(P(\text{dữ liệu} \mid H_0)\). Câu nói lại diễn giải nó như \(P(H_0 \mid \text{dữ liệu})\), xác suất để "chỉ là may rủi". Muốn có xác suất sau, phải có tiên nghiệm của \(H_0\) và dùng định lý Bayes; với một giả thuyết vốn rất khó tin, \(H_0\) vẫn có thể rất có khả năng đúng dù \(p = 0{,}03\) (Ví dụ 3).
A4. Vì sao một bảng xếp hạng "các trường có tỉ lệ đỗ đại học cao nhất", tính trên những học sinh mà mỗi trường cho dự thi, có thể dẫn tới kết luận sai về chất lượng dạy học?
Lời giải
Nếu các trường tự chọn học sinh nào được dự thi, một trường có thể chỉ cho những em giỏi nhất đi thi: tỉ lệ đỗ cao đến từ việc chọn mẫu, không phải từ việc dạy. Đó là thiên lệch chọn mẫu, và gần với thiên lệch sống sót: những học sinh bị "lọc" không xuất hiện trong mẫu số. Muốn so chất lượng dạy, phải tính trên mọi học sinh của trường, và nếu được, so những học sinh có đầu vào giống nhau.
B. Tính toán
B1. Hai thuốc giảm đau được dùng cho hai nhóm tuổi (số liệu giả định). Thuốc X: dưới 60 tuổi có tác dụng với 45 trong 50 người, từ 60 tuổi với 105 trong 150 người. Thuốc Y: dưới 60 tuổi 136 trong 160 người, từ 60 tuổi 26 trong 40 người. Tính các tỉ lệ theo nhóm và khi gộp; rồi tính tỉ lệ gộp của mỗi thuốc nếu cả hai được dùng cho cùng cơ cấu tuổi của toàn bộ 400 người.
Lời giải
X: 90% và 70%; Y: 85% và 65%. X hơn Y ở cả hai nhóm. Gộp: X là \(\frac{150}{200} = 75\%\), Y là \(\frac{162}{200} = 81\%\): Y hơn. Toàn bộ 400 người có \(50 + 160 = 210\) người dưới 60 tuổi và 190 người từ 60 tuổi, tức trọng số \(0{,}525\) và \(0{,}475\). Với cùng cơ cấu ấy: X là \(0{,}525 \cdot 0{,}9 + 0{,}475 \cdot 0{,}7 = 0{,}805\), Y là \(0{,}525 \cdot 0{,}85 + 0{,}475 \cdot 0{,}65 = 0{,}755\). So trên cùng một cơ cấu, X tốt hơn, đúng như Mệnh đề 2 dự báo.
B2. Làm 10 phép thử độc lập ở mức 5% khi mọi giả thuyết không đều đúng. Tính xác suất có ít nhất một dương tính giả, và ngưỡng mỗi phép thử theo hiệu chỉnh Bonferroni để giữ xác suất ấy dưới 5%.
Lời giải
\(1 - 0{,}95^{10} \approx 0{,}40\). Ngưỡng Bonferroni: \(\frac{0{,}05}{10} = 0{,}005\) cho mỗi phép thử.
B3. Một nghiên cứu kiểm tra 1000 giả thuyết; thật ra 100 giả thuyết đúng (có tác dụng thật) và 900 là giả thuyết không đúng. Mỗi phép thử ở mức 5% phát hiện được một tác dụng thật với xác suất 80% (giả định). Trong số các kết quả "có ý nghĩa", bao nhiêu phần là dương tính giả?
Lời giải
Tác dụng thật được phát hiện: \(100 \cdot 0{,}8 = 80\). Dương tính giả: \(900 \cdot 0{,}05 = 45\). Có \(80 + 45 = 125\) kết quả có ý nghĩa, trong đó \(\frac{45}{125} = 36\%\) là dương tính giả. Mức 5% không có nghĩa là 5% số phát hiện là sai: tỉ lệ ấy phụ thuộc vào tỉ lệ nền của các giả thuyết đúng, như ở Chương 43.
B4. Tung đồng xu 10 lần được 8 lần ngửa. Tính giá trị p một phía (từ 8 lần ngửa trở lên) và hai phía với giả thuyết không "đồng xu cân đối". Kết quả có ý nghĩa thống kê ở mức 5% không?
Lời giải
Một phía: \(\frac{\binom{10}{8} + \binom{10}{9} + \binom{10}{10}}{2^{10}} = \frac{45 + 10 + 1}{1024} = \frac{56}{1024} \approx 0{,}055\). Hai phía gấp đôi, khoảng \(0{,}109\). Cả hai đều lớn hơn \(0{,}05\): không có ý nghĩa thống kê. Với chỉ 10 lần tung, 8 lần ngửa chưa đủ để nghi ngờ đồng xu.
B5. Một thuốc làm giảm nguy cơ mắc một bệnh trong 5 năm từ 4% xuống 3% (giả định). Tính mức giảm tương đối, mức giảm tuyệt đối, và số người phải dùng thuốc để tránh được một ca bệnh, gọi là số người cần điều trị (number needed to treat).
Lời giải
Giảm tương đối: \(\frac{4 - 3}{4} = 25\%\). Giảm tuyệt đối: 1 điểm phần trăm. Số người cần điều trị: \(\frac{1}{0{,}01} = 100\) người dùng thuốc trong 5 năm thì tránh được khoảng một ca. "Giảm 25% nguy cơ" và "100 người dùng để một người được lợi" là cùng một sự thật.
B6. Lương tháng của năm người là 8, 9, 10, 12 và 61 triệu đồng (giả định). Tính trung bình và trung vị. Nếu lương người cao nhất tăng gấp đôi, hai con số ấy thay đổi thế nào?
Lời giải
Trung bình \(\frac{8 + 9 + 10 + 12 + 61}{5} = 20\) triệu; trung vị 10 triệu. Nếu 61 thành 122: trung bình \(\frac{161}{5} = 32{,}2\) triệu, còn trung vị vẫn là 10 triệu. Một người thay đổi kéo trung bình lên 12,2 triệu mà không ai khác được tăng lương.
B7. Mười quỹ đầu tư có lợi nhuận trung bình mỗi năm là \(-8\%\), \(-5\%\), \(-3\%\), \(-1\%\), \(2\%\), \(4\%\), \(6\%\), \(9\%\), \(11\%\), \(15\%\) (giả định). Các quỹ có lợi nhuận âm đã đóng cửa. Tính lợi nhuận trung bình của cả mười quỹ và của các quỹ còn lại.
Lời giải
Cả mười quỹ: \(\frac{-8 - 5 - 3 - 1 + 2 + 4 + 6 + 9 + 11 + 15}{10} = \frac{30}{10} = 3\%\). Sáu quỹ còn lại: \(\frac{2 + 4 + 6 + 9 + 11 + 15}{6} = \frac{47}{6} \approx 7{,}8\%\). Một người chỉ thấy các quỹ còn hoạt động sẽ đánh giá lợi nhuận "điển hình" cao gấp hơn hai lần sự thật.
B8. Như Ví dụ 6 (trung bình 130, độ lệch chuẩn 15, hệ số tương quan \(0{,}5\)), một người có lần đo đầu đúng 160. Lần đo sau của người ấy được dự đoán là bao nhiêu nếu không có can thiệp gì?
Lời giải
160 có điểm z bằng 2. Theo đường hồi quy, điểm z dự đoán của lần sau là \(0{,}5 \cdot 2 = 1\), tức \(130 + 15 = 145\). Mức "giảm" 15 mmHg được dự đoán mà không có can thiệp nào.
B9. Hai nhóm, mỗi nhóm \(n\) người, được so về cân nặng trung bình; độ lệch chuẩn cân nặng là 5 kg. Độ lệch chuẩn của hiệu hai trung bình là \(5\sqrt{\frac{2}{n}}\). Tính khoảng cách, tính bằng số độ lệch chuẩn, của hiệu \(0{,}1\) kg với \(n = 1.000.000\), và của hiệu 2 kg với \(n = 100\).
Lời giải
\(n = 1.000.000\): độ lệch chuẩn của hiệu là \(5\sqrt{2 \cdot 10^{-6}} \approx 0{,}0071\) kg, nên \(0{,}1\) kg cách 0 khoảng 14 độ lệch chuẩn. \(n = 100\): độ lệch chuẩn là \(5\sqrt{0{,}02} \approx 0{,}71\) kg, nên 2 kg cách 0 khoảng \(2{,}8\) độ lệch chuẩn. Cả hai đều có ý nghĩa thống kê ở mức 5%, nhưng chỉ khác biệt thứ hai đáng kể với một người muốn giảm cân.
C. Phản ví dụ và chứng minh
C1. Cho ba số \(a \leq b \leq c\). Chứng minh hàm \(g(t) = \lvert t - a \rvert + \lvert t - b \rvert + \lvert t - c \rvert\) nhỏ nhất tại \(t = b\), trung vị của ba số. (Trung bình làm tổng bình phương sai lệch nhỏ nhất, bài C2 Chương 44; trung vị làm tổng trị tuyệt đối sai lệch nhỏ nhất.)
Lời giải
Với \(a \leq t \leq c\): \(\lvert t - a \rvert + \lvert t - c \rvert = (t - a) + (c - t) = c - a\), nên \(g(t) = (c - a) + \lvert t - b \rvert \geq c - a = g(b)\). Với \(t < a\): \(g(t) = (a - t) + (b - t) + (c - t) > (c - a) + 0\), vì \(b - t > 0\), \(a - t > 0\) và \((a - t) + (c - t) > c - a\). Tương tự với \(t > c\). Vậy \(g(t) \geq g(b)\) với mọi \(t\). \(\square\)
C2. Chứng minh bằng quy nạp rằng với mọi biến cố \(A_1, \dots, A_m\), \(P(A_1 \cup \dots \cup A_m) \leq P(A_1) + \dots + P(A_m)\).
Lời giải
Với \(m = 1\), hai vế bằng nhau. Giả sử đúng với \(m\). Đặt \(B = A_1 \cup \dots \cup A_m\). Theo Định lý 2 Chương 41, \(P(B \cup A_{m+1}) = P(B) + P(A_{m+1}) - P(B \cap A_{m+1}) \leq P(B) + P(A_{m+1})\), và theo giả thiết quy nạp \(P(B) \leq P(A_1) + \dots + P(A_m)\). Cộng lại được điều phải chứng minh cho \(m + 1\). \(\square\)
C3. Chứng minh rằng nếu hai bên có cùng số phần tử trong mỗi nhóm, tức \(b_1 = d_1\) và \(b_2 = d_2\), thì nghịch lý Simpson không thể xảy ra.
Lời giải
Từ \(\frac{a_1}{b_1} > \frac{c_1}{b_1}\) và \(\frac{a_2}{b_2} > \frac{c_2}{b_2}\) suy ra \(a_1 > c_1\) và \(a_2 > c_2\), nên \(a_1 + a_2 > c_1 + c_2\), và chia cho cùng một số \(b_1 + b_2 = d_1 + d_2\): \(\frac{a_1 + a_2}{b_1 + b_2} > \frac{c_1 + c_2}{d_1 + d_2}\). \(\square\) Đây là trường hợp riêng của Mệnh đề 2: cùng số phần tử trong mỗi nhóm thì cùng cơ cấu.
Câu hỏi để ngỏ
Dữ liệu thật có nhiều chiều: một khách hàng có tuổi, thu nhập, lịch sử mua hàng; một từ trong mô hình ngôn ngữ được biểu diễn bởi hàng trăm con số. Làm sao làm toán với những "điểm" sống trong không gian nhiều chiều?