Chương 59: Toán trong cách AI hoạt động
Câu hỏi mở đầu
Một cỗ máy có thể "học" để chơi trò chơi, trả lời câu hỏi, viết văn. Nó dùng những công cụ nào trong số những gì ta đã học, và hiểu chúng giúp ta kiểm chứng nó như thế nào?
Một cỗ máy đoán chữ tiếp theo
"Hôm nay trời rất ..." Từ tiếp theo là gì? Bạn đoán được ngay: "đẹp", "nóng", "lạnh" có vẻ hợp; "vuông" thì không. Một mô hình ngôn ngữ làm đúng việc ấy, chỉ ở quy mô khổng lồ: nhận đoạn văn bản đã có, trả ra một phân phối xác suất cho mẩu văn bản tiếp theo, chọn ngẫu nhiên một mẩu theo phân phối ấy, nối vào, rồi lặp lại. Mỗi mẩu như thế, một từ, một phần của từ hay một dấu câu, gọi là một token (token). Một câu trả lời dài là hàng trăm lần đoán liên tiếp.
Muốn làm được, mọi thứ phải thành con số. Mỗi token được biểu diễn bằng một vector (Chương 49). Mô hình là một hàm rất lớn, xây bằng hợp của nhiều tầng (Chương 24): mỗi tầng nhân với một ma trận (Chương 51) rồi áp một hàm kích hoạt phi tuyến lên từng thành phần, vì không có hàm kích hoạt thì mọi tầng gộp lại chỉ là một ma trận (Chương 52, Ví dụ 6). Tầng cuối cho mỗi token có thể xuất hiện một điểm số, và một hàm dựa trên hàm mũ (Chương 29) biến các điểm số ấy thành xác suất.
flowchart TD
  X["văn bản đã có"] --> V["mỗi token thành một vector"]
  V --> T["nhiều tầng: nhân ma trận, rồi áp hàm kích hoạt"]
  T --> D["một điểm số cho mỗi token có thể xuất hiện"]
  D --> S["xác suất cho mỗi token"]
  S --> M["chọn ngẫu nhiên token tiếp theo"]
  M -->|"nối vào rồi lặp lại"| X
Các số trong những ma trận ấy, có khi tới hàng tỉ số, là các tham số của mô hình. Không ai điền chúng bằng tay. Chúng được điều chỉnh dần để mô hình ít "bất ngờ" nhất trước những văn bản thật: mỗi lần mô hình gán xác suất nhỏ cho token thật sự xuất hiện tiếp theo, một con số đo mức sai được tính ra, và mọi tham số được xê dịch một chút theo hướng làm con số ấy nhỏ đi. Đó là hạ gradient của Chương 56, với đạo hàm theo hàng tỉ tham số tính bằng quy tắc hợp (Chương 35) đi ngược qua các tầng. Cách xây chương trình bằng điều chỉnh tham số theo dữ liệu như thế, thay vì viết ra từng quy tắc, gọi là học máy (machine learning).
Vì sao cấu trúc này phải xuất hiện, dù chưa ai đặt tên cho nó? Vì một cỗ máy phải trả lời tốt cả những câu nó chưa từng gặp thì cần ba thứ, và mỗi thứ bị ép ra bởi yêu cầu ấy. Nó cần một họ hàm đủ linh hoạt, mà cách đơn giản nhất để có hàm phức tạp là ghép nhiều hàm đơn giản. Nó cần một con số đo nó sai bao nhiêu, vì không đo được thì không cải thiện được. Và nó cần biết xê dịch tham số theo hướng nào, tức đạo hàm. Ba thứ ấy là hợp hàm, tối ưu và quy tắc hợp: những chương đã qua của cuốn sách. Cũng vì đầu ra là một phân phối xác suất cho văn bản tiếp theo, chứ không phải kết quả của một phép kiểm tra sự thật, mô hình có thể trôi chảy, tự tin và sai: đúng lời cảnh báo của Chương 2, giờ có lời giải thích.
Ký hiệu
Một mô hình là một hàm \(f_\theta\), với \(\theta\) là danh sách các tham số. Một hàm mất mát (loss function) \(L(\theta)\) đo mức sai của mô hình trên dữ liệu; học là tìm \(\theta\) làm \(L\) nhỏ, thường bằng hạ gradient \(\theta \leftarrow \theta - \eta \nabla L(\theta)\). Tính gradient ấy bằng quy tắc hợp, từ tầng cuối ngược về tầng đầu, gọi là lan truyền ngược (backpropagation).
Với điểm số \(z = (z_1; \dots; z_n)\) của \(n\) token, hàm softmax (softmax function) cho xác suất
Chia mọi điểm số cho một số \(T > 0\) trước khi áp softmax, tức dùng \(\frac{z}{T}\), là chỉnh nhiệt độ (temperature): nhiệt độ thấp làm phân phối nhọn, dồn vào token có điểm cao nhất; nhiệt độ cao làm phân phối phẳng. Sau đó mô hình chọn một token ngẫu nhiên theo phân phối ấy, tức lấy mẫu từ nó.
Nếu token đúng là token thứ \(k\), mức sai của mô hình trên ví dụ ấy là
gọi là entropy chéo (cross-entropy) của ví dụ. Con số \(-\ln p\) có một tên gợi hình: độ ngạc nhiên (surprisal) khi một điều có xác suất \(p\) xảy ra. Điều chắc chắn (\(p = 1\)) không gây ngạc nhiên nào, điều hiếm (\(p\) gần 0) gây ngạc nhiên rất lớn, và nhờ logarit (Chương 13), độ ngạc nhiên của hai biến cố độc lập cộng với nhau.
Vector biểu diễn một token gọi là vector từ (word embedding); hai từ có nghĩa gần nhau thì có vector gần cùng hướng, đo bằng độ tương đồng côsin của Chương 49. Cuối cùng, một mô hình khớp quá sát với dữ liệu đã học mà đoán kém trên dữ liệu mới gọi là quá khớp (overfitting). Muốn biết mô hình tốt tới đâu, phải thử nó trên dữ liệu kiểm tra (test data): dữ liệu không được dùng khi điều chỉnh tham số.
Làm bằng tay
Ví dụ 1 (softmax). Ba token có điểm \((2; 1; 0)\). Vì \(e^2 \approx 7{,}389\), \(e^1 \approx 2{,}718\), \(e^0 = 1\), tổng là \(11{,}107\) và xác suất là
Mọi xác suất dương, tổng bằng 1, và điểm cao hơn cho xác suất cao hơn. Hơn một đơn vị điểm nghĩa là gấp \(e \approx 2{,}7\) lần về xác suất.
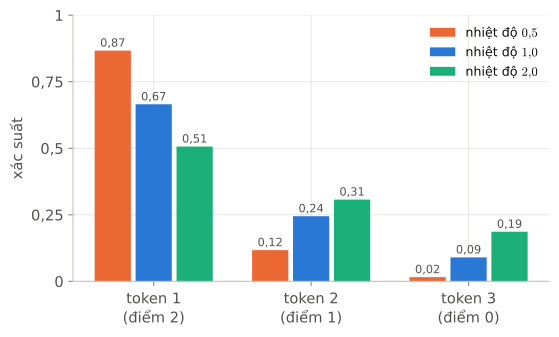
Ví dụ 2 (nhiệt độ). Cùng điểm số, với nhiệt độ \(0{,}5\) ta dùng \((4; 2; 0)\) và được khoảng \((0{,}867; 0{,}117; 0{,}016)\); với nhiệt độ 2 ta dùng \((1; 0{,}5; 0)\) và được khoảng \((0{,}506; 0{,}307; 0{,}186)\). Nhiệt độ thấp gần như luôn chọn token 1; nhiệt độ cao cho các token khác nhiều cơ hội hơn, nên văn bản đa dạng hơn nhưng cũng dễ lạc hơn.
Bàn tương tác: softmax và nhiệt độ
Bàn mở ra với điểm số \((2; 1; 0)\) của Ví dụ 1 ở nhiệt độ 1. Đổi điểm số và nhiệt độ, rồi bấm các nút. Cộng cùng một số vào mọi điểm thì các xác suất thay đổi thế nào? Hạ nhiệt độ thì phân phối ra sao, và khi lấy mẫu, token có điểm thấp còn được chọn không?
Bàn tương tác cần trình duyệt bật JavaScript.
Điều bạn vừa thấy
Softmax chỉ nhìn hiệu giữa các điểm: cộng hay trừ cùng một số vào mọi điểm không đổi xác suất nào, và tỉ số của hai xác suất là \(e\) mũ hiệu hai điểm chia cho \(T\). Nhiệt độ chia mọi hiệu ấy: \(T\) nhỏ phóng to các hiệu, dồn xác suất vào token có điểm cao nhất; \(T\) lớn thu nhỏ chúng, kéo mọi xác suất về gần \(\frac13\). Nhưng ngay ở nhiệt độ \(0{,}5\), token 1 của Ví dụ 1 chỉ có xác suất khoảng \(0{,}87\): lấy mẫu 100 lần, các token khác vẫn được chọn chừng một chục lần.
Ví dụ 3 (entropy chéo). Nếu token đúng là token 1, mất mát của mô hình ở Ví dụ 1 là \(-\ln 0{,}665 \approx 0{,}408\). Nếu token đúng là token 3, mất mát là \(-\ln 0{,}090 \approx 2{,}41\): mô hình "ngạc nhiên" hơn nhiều, và bị phạt nặng hơn. Học là làm nhỏ trung bình của các con số ấy trên rất nhiều văn bản. Đạo hàm của mất mát theo các điểm số rất gọn: nó là \(p - y\), với \(y\) là vector có 1 ở vị trí token đúng và 0 ở chỗ khác (Mệnh đề 5). Với token đúng là token 1, đó là \((0{,}665 - 1; 0{,}245; 0{,}090)\): hạ gradient sẽ tăng điểm của token đúng và giảm điểm của hai token kia.
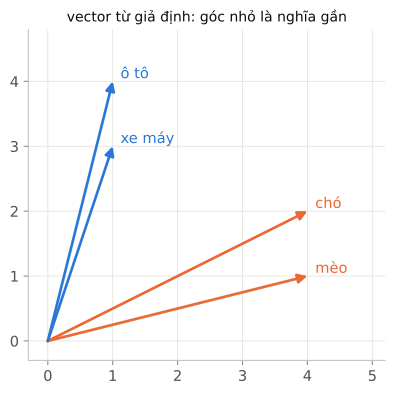
Ví dụ 4 (vector từ). Giả định bốn từ được biểu diễn trong mặt phẳng: mèo \((4; 1)\), chó \((4; 2)\), ô tô \((1; 4)\), xe máy \((1; 3)\). Độ tương đồng côsin giữa mèo và chó là \(\frac{16 + 2}{\sqrt{17}\sqrt{20}} \approx 0{,}976\); giữa mèo và ô tô là \(\frac{4 + 4}{\sqrt{17}\sqrt{17}} = \frac{8}{17} \approx 0{,}471\); giữa ô tô và xe máy là \(\frac{1 + 12}{\sqrt{17}\sqrt{10}} \approx 0{,}997\). Các mô hình thật dùng vector có hàng trăm tới hàng nghìn chiều, và các vector ấy không ai đặt tay: chúng cũng là tham số, được học từ dữ liệu.
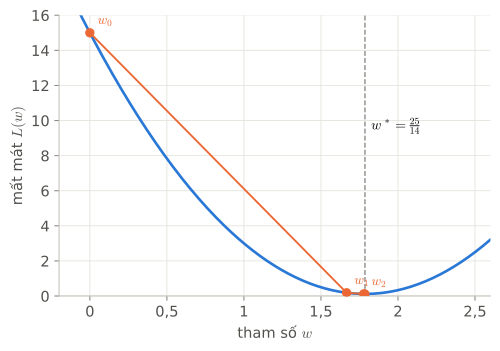
Ví dụ 5 (học một tham số). Ba điểm dữ liệu (giả định) \((1; 2)\), \((2; 4)\), \((3; 5)\), và mô hình \(y \approx wx\) với một tham số \(w\). Mất mát là trung bình bình phương sai số:
Xuất phát từ \(w_0 = 0\) (\(L = 15\)) với bước học \(0{,}1\): \(L'(0) = -\frac{50}{3}\), nên \(w_1 = \frac{5}{3} \approx 1{,}667\) và \(L(w_1) = \frac{5}{27} \approx 0{,}185\); rồi \(L'(w_1) = -\frac{10}{9}\), nên \(w_2 = \frac{16}{9} \approx 1{,}778\). Giá trị tốt nhất là nghiệm của \(L'(w) = 0\), tức \(w^* = \frac{25}{14} \approx 1{,}786\), đúng là công thức bình phương nhỏ nhất của đường hồi quy (Chương 47) cho đường đi qua gốc. Hạ gradient không biết công thức ấy; nó chỉ biết độ dốc dưới chân, và vẫn tới nơi.
Bàn tương tác: học là hạ gradient
Bàn mở ra với dữ liệu và bước học của Ví dụ 5: hai bước từ \(w_0 = 0\). Tăng số bước, đổi bước học và điểm xuất phát, rồi kéo các điểm dữ liệu. Hạ gradient có cần biết công thức của \(w^*\) không? Với bước học nào thì \(w\) trượt thẳng vào, với bước học nào thì nhảy qua lại, và từ đâu thì hỏng?
Bàn tương tác cần trình duyệt bật JavaScript.
Điều bạn vừa thấy
Hạ gradient chỉ dùng độ dốc \(L'(w)\) tại chỗ đang đứng, vậy mà với bước học đủ nhỏ, nó tới đúng \(w^*\) với mọi bộ dữ liệu. Vì \(L\) là một parabol, mỗi bước nhân khoảng cách tới \(w^*\) với cùng một số \(1 - \frac{28}{3}\eta\), như cái bát của Chương 56. Số ấy dương thì \(w\) trượt dần vào; âm thì \(w\) nhảy qua lại quanh \(w^*\) trong lúc tiến vào; trị tuyệt đối vượt 1, tức \(\eta > \frac{3}{14}\), thì \(w\) văng ra. Kéo dữ liệu chỉ dời \(w^*\) và đáy của parabol: độ cong của parabol, và vì thế ngưỡng của bước học, chỉ phụ thuộc các hoành độ 1, 2, 3.
Ví dụ 6 (một mạng hai tầng và lan truyền ngược). Một mạng tí hon nhận \(x\), tính \(z = w_1 x\), rồi \(h = \max(0; z)\) (hàm kích hoạt đổi số âm thành 0), rồi đầu ra \(\hat y = w_2 h\); mất mát là \(L = (\hat y - y)^2\). Với \(x = 2\), \(y = 3\), \(w_1 = 0{,}5\), \(w_2 = 2\): chiều thuận cho \(z = 1\), \(h = 1\), \(\hat y = 2\), \(L = 1\). Chiều ngược, theo quy tắc hợp, nhân các đạo hàm cục bộ từ cuối về đầu:
trong đó thừa số 1 là đạo hàm của \(\max(0; z)\) tại \(z = 1 > 0\). Một bước hạ gradient với bước học \(0{,}02\) cho \(w_2 = 2{,}04\), \(w_1 = 0{,}66\); chạy lại chiều thuận: \(z = 1{,}32\), \(\hat y \approx 2{,}693\), \(L \approx 0{,}094\). Mất mát giảm từ 1 xuống dưới \(0{,}1\) sau một bước. Mô hình thật làm đúng những việc này, chỉ với hàng tỉ tham số thay cho hai.
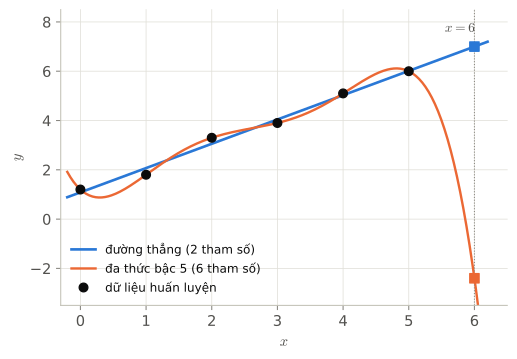
Ví dụ 7 (quá khớp). Sáu điểm dữ liệu (giả định) tại \(x = 0, 1, \dots, 5\) với \(y = 1{,}2;\ 1{,}8;\ 3{,}3;\ 3{,}9;\ 5{,}1;\ 6{,}0\). Đường thẳng bình phương nhỏ nhất (hai tham số) là \(y \approx 1{,}086 + 0{,}986x\), sai lệch nhỏ ở mọi điểm. Đa thức bậc 5 (sáu tham số) đi qua đúng cả sáu điểm: mất mát trên dữ liệu đã học bằng 0. Nhưng tại một điểm mới \(x = 6\), đường thẳng đoán \(7{,}0\) còn đa thức đoán \(-2{,}4\), vì nó đã "học thuộc" cả những dao động ngẫu nhiên của dữ liệu. Mất mát nhỏ trên dữ liệu đã học chưa nói gì về dữ liệu mới. Chỉ có dữ liệu kiểm tra mới cho biết điều đó, và theo luật số lớn (Chương 45), trung bình sai số trên nhiều ví dụ kiểm tra độc lập là một ước lượng tốt của sai số thật.
Bàn tương tác: quá khớp
Bàn mở ra với sáu điểm của Ví dụ 7 và đường thẳng, tức đa thức bậc 1. Tăng bậc từng nấc và theo dõi bảng: mất mát trên dữ liệu học và trên dữ liệu kiểm tra thay đổi thế nào? Rồi kéo lệch một điểm dữ liệu học một chút: đường thẳng hay đa thức bậc 5 đổi nhiều hơn?
Bàn tương tác cần trình duyệt bật JavaScript.
Điều bạn vừa thấy
Càng nhiều tham số, đa thức càng bám sát dữ liệu học: mất mát trên dữ liệu học chỉ giảm, và bằng 0 ở bậc 5, khi sáu tham số đủ để đi qua cả sáu điểm. Mất mát trên dữ liệu kiểm tra thì giảm rồi tăng: thấp nhất ở bậc 1 và bậc 2, gần như ngang nhau, rồi vọt lên ở bậc 5, chủ yếu vì dự đoán tại \(x = 6\). Kéo lệch một điểm, đường thẳng chỉ nghiêng đi một chút, còn đa thức bậc 5 uốn theo cả chỗ lệch ấy và đổi mạnh ở những chỗ xa dữ liệu. Mất mát trên dữ liệu học không cho biết mô hình đoán tốt tới đâu trên dữ liệu mới; chỉ dữ liệu kiểm tra mới cho biết điều đó.
Ranh giới
Xác suất cao không có nghĩa là đúng. Mô hình gán xác suất cho những đoạn văn nghe hợp lý, dựa trên những gì nó đã đọc; không bước nào trong quy trình kiểm tra điều nó nói có đúng với thế giới không. Lời giải sai "chia hai vế cho \(x\)" ở Ví dụ 2 của Chương 2 là một chuỗi token rất "hợp lý" theo nghĩa ấy. Hạ nhiệt độ chỉ làm mô hình chọn đáp án nó cho là có khả năng nhất, không làm đáp án ấy đúng hơn. Vì thế vai trò kiểm chứng của con người, bằng trường hợp biên, bằng làm ngược lại, bằng tự dựng lại lập luận như Chương 2 đã dạy, là thiết yếu.
Tương quan trong dữ liệu không phải nhân quả. Mô hình học những gì thường đi cùng nhau trong dữ liệu. Như Chương 47 đã chỉ ra, đi cùng nhau không có nghĩa là cái này gây ra cái kia; một mô hình dự đoán giỏi vẫn có thể gợi ý những can thiệp sai.
Mô hình học cả thiên lệch của dữ liệu. Nếu dữ liệu nghiêng về một nhóm, một quan điểm hay một thời kỳ, mô hình cũng nghiêng theo, như các thiên lệch chọn mẫu của Chương 48. Mô hình không thể tốt hơn dữ liệu về những điều dữ liệu không chứa.
Hạ gradient chỉ bảo đảm tới cực tiểu địa phương. Với hàng tỉ tham số, không ai biết mô hình đã tới cực tiểu tốt nhất hay chưa (Chương 56); thực tế cho thấy các cực tiểu tìm được thường đủ tốt, nhưng đó là quan sát, không phải định lý.
Nhiều tham số hơn không tự động tốt hơn. Ví dụ 7 cho thấy một mô hình đủ linh hoạt có thể học thuộc cả nhiễu. Chỉ đánh giá trên dữ liệu kiểm tra mới trả lời được câu hỏi mô hình có thật sự nắm được quy luật hay không.
Phát biểu chặt chẽ
Định nghĩa 1. Với \(z = (z_1; \dots; z_n) \in \mathbb{R}^n\) và \(T > 0\), softmax ở nhiệt độ \(T\) là vector \(p\) với \(p_i = \dfrac{e^{z_i / T}}{\sum_{j=1}^{n} e^{z_j / T}}\); khi \(T = 1\) ta gọi đơn giản là softmax của \(z\).
Mệnh đề 2. Softmax là một phân phối xác suất trên \(n\) token: mọi \(p_i > 0\) và \(p_1 + \dots + p_n = 1\). Ngoài ra \(z_i > z_j\) khi và chỉ khi \(p_i > p_j\).
Chứng minh. Hàm mũ chỉ nhận giá trị dương, nên tử và mẫu đều dương. Tổng các \(p_i\) là \(\frac{\sum_i e^{z_i/T}}{\sum_j e^{z_j/T}} = 1\). Vì các \(p_i\) có chung mẫu, \(p_i > p_j\) khi và chỉ khi \(e^{z_i/T} > e^{z_j/T}\), tức \(z_i > z_j\), do hàm mũ tăng. Vậy softmax thỏa các tiên đề xác suất trên một tập hữu hạn (Chương 41). \(\square\)
Mệnh đề 3 (dịch điểm số). Với mọi số \(c\), softmax của \((z_1 + c; \dots; z_n + c)\) bằng softmax của \(z\).
Chứng minh. \(\frac{e^{(z_i + c)/T}}{\sum_j e^{(z_j + c)/T}} = \frac{e^{c/T} e^{z_i/T}}{e^{c/T} \sum_j e^{z_j/T}} = \frac{e^{z_i/T}}{\sum_j e^{z_j/T}}\). \(\square\)
Trên máy tính, \(e^{1000}\) vượt quá mọi số biểu diễn được; nhờ Mệnh đề 3, ta trừ điểm lớn nhất khỏi mọi điểm trước khi tính, và kết quả không đổi (bài B9).
Định nghĩa 4. Cho điểm số \(z\), xác suất \(p\) là softmax của \(z\), và token đúng \(k\); gọi \(y\) là vector có \(y_k = 1\) và \(y_i = 0\) với \(i \neq k\). Entropy chéo của ví dụ là \(L(z) = -\ln p_k = -\sum_i y_i \ln p_i\).
Mệnh đề 5 (đạo hàm của entropy chéo). \(\dfrac{\partial L}{\partial z_i} = p_i - y_i\) với mọi \(i\).
Chứng minh. Viết \(L(z) = -\ln \frac{e^{z_k}}{\sum_j e^{z_j}} = -z_k + \ln \sum_j e^{z_j}\). Đạo hàm riêng theo \(z_i\) của số hạng đầu là \(-1\) nếu \(i = k\) và 0 nếu không, tức \(-y_i\); của số hạng sau, theo quy tắc hợp, là \(\frac{e^{z_i}}{\sum_j e^{z_j}} = p_i\). \(\square\)
Mệnh đề 6 (nhiệt độ). Giả sử \(z_m\) là điểm lớn nhất và lớn hơn hẳn mọi điểm khác. Khi \(T \to 0\) với \(T > 0\), \(p_m \to 1\) và \(p_i \to 0\) với \(i \neq m\). Khi \(T \to +\infty\), mọi \(p_i \to \frac1n\).
Chứng minh. \(\frac{p_i}{p_m} = e^{(z_i - z_m)/T}\). Với \(i \neq m\), \(z_i - z_m < 0\), nên khi \(T \to 0\) số mũ tiến về \(-\infty\) và tỉ số tiến về 0; vì \(\sum_i \frac{p_i}{p_m} = \frac{1}{p_m}\), ta có \(\frac{1}{p_m} \to 1\), tức \(p_m \to 1\), và \(p_i \to 0\). Khi \(T \to +\infty\), mọi số mũ \(\frac{z_i - z_m}{T} \to 0\), nên mọi tỉ số \(\frac{p_i}{p_m} \to 1\); khi ấy \(\frac{1}{p_m} = \sum_i \frac{p_i}{p_m} \to n\), và mọi \(p_i \to \frac1n\). \(\square\)
Mệnh đề 7 (đạo hàm của một dây chuyền). Cho các hàm khả vi \(f_1, \dots, f_m\) và \(x_0 = x\), \(x_k = f_k(x_{k-1})\). Khi đó \((f_m \circ \dots \circ f_1)'(x) = f_m'(x_{m-1}) \cdots f_2'(x_1) \cdot f_1'(x_0)\).
Chứng minh. Quy nạp theo \(m\). Với \(m = 1\) là hiển nhiên. Nếu đúng với \(m\), thì theo quy tắc hợp của Chương 35, \(\big(f_{m+1} \circ (f_m \circ \dots \circ f_1)\big)'(x) = f_{m+1}'(x_m) \cdot (f_m \circ \dots \circ f_1)'(x)\), rồi dùng giả thiết quy nạp. \(\square\)
Lan truyền ngược là cách tính tích này từ trái sang phải, tức từ tầng cuối về tầng đầu: mỗi tầng chỉ cần nhân kết quả nhận từ tầng sau với đạo hàm cục bộ của mình, như ở Ví dụ 6. Với nhiều biến, các đạo hàm cục bộ là ma trận và các tích là tích ma trận, nhưng cấu trúc không đổi.
Sợi chỉ
Chương cuối gom cả bảy sợi chỉ của cuốn sách.
- S1. Bất biến qua biến đổi. Softmax không đổi khi cộng cùng một số vào mọi điểm (Mệnh đề 3); từ lớp tương đương ở Chương 3 tới cân bằng Nash ở Chương 58, tìm cái không đổi là cách nhìn ra cấu trúc.
- S2. Thông tin và khả nghịch. Một mô hình nén hàng tỉ trang văn bản vào các tham số, và mọi phép nén mất thông tin (Chương 6, Chương 54); độ ngạc nhiên \(-\ln p\) đo lượng thông tin của một biến cố.
- S3. Thứ tự của biến đổi. Các tầng là hợp hàm, và hợp hàm không giao hoán (Chương 24, Chương 52); lan truyền ngược đi đúng thứ tự ngược với chiều thuận, như tháo giày trước khi tháo tất.
- S4. Cục bộ và toàn cục. Hạ gradient chỉ nhìn độ dốc dưới chân mà đi được rất xa, nhưng không bảo đảm tới đáy sâu nhất; khớp tốt từng điểm dữ liệu (cục bộ) không có nghĩa là đoán tốt trên dữ liệu mới (toàn cục).
- S5. Rời rạc và liên tục. Token là rời rạc, vector và xác suất là liên tục; mô hình đi qua lại giữa hai thế giới, như tổng Riemann và tích phân ở Chương 37.
- S6. Biểu diễn khác nhau của cùng một cấu trúc. Một từ thành một vector, nghĩa gần thành góc nhỏ; bài toán bình phương nhỏ nhất của Chương 47 thành một phép hạ gradient.
- S7. Xấp xỉ và sai số. Hàm mất mát đo sai số của một phép xấp xỉ; dữ liệu kiểm tra và luật số lớn cho biết sai số ấy trên thế giới thật; và như Chương 2 đã dạy từ đầu, mọi đầu ra là một khẳng định cần kiểm chứng.
Tóm tắt
- Một mô hình ngôn ngữ đoán phân phối xác suất của token tiếp theo, lấy mẫu một token, nối vào và lặp lại.
- Mô hình là hợp của nhiều tầng: nhân ma trận xen với hàm kích hoạt phi tuyến; các số trong ma trận là tham số.
- Softmax biến điểm số thành xác suất; nó không đổi khi dịch mọi điểm; nhiệt độ làm phân phối nhọn hay phẳng.
- Học là làm nhỏ một hàm mất mát, như entropy chéo \(-\ln p_k\), bằng hạ gradient; đạo hàm của entropy chéo theo điểm số là \(p - y\).
- Lan truyền ngược là quy tắc hợp áp dụng từ tầng cuối về tầng đầu.
- Từ được biểu diễn bằng vector và so sánh bằng độ tương đồng côsin.
- Mất mát nhỏ trên dữ liệu đã học chưa đủ: phải kiểm tra trên dữ liệu mới để phát hiện quá khớp.
- Xác suất cao không phải sự thật; mô hình học cả tương quan lẫn thiên lệch của dữ liệu, nên kiểm chứng của con người là thiết yếu.
Bài tập
A. Tư duy
A1. Vì sao một mạng nơ-ron cần hàm kích hoạt phi tuyến giữa các tầng?
Lời giải
Nếu các tầng chỉ nhân ma trận, thì theo Hệ quả 4 của Chương 52, cả dây chuyền gộp lại thành một ma trận duy nhất: thêm tầng không thêm được khả năng nào, và mô hình chỉ biểu diễn được những biến đổi tuyến tính. Hàm kích hoạt phi tuyến phá sự gộp ấy, và nhờ đó hợp của nhiều tầng biểu diễn được những hàm phức tạp.
A2. Vì sao một mô hình ngôn ngữ có thể trả lời sai mà giọng rất tự tin?
Lời giải
Vì mô hình được học để đoán những đoạn văn nghe hợp lý, không phải để kiểm tra sự thật. Một lời giải sai nhưng viết theo khuôn mẫu quen thuộc, như "chia hai vế cho \(x\)" ở Chương 2, có thể có xác suất cao. Giọng văn tự tin cũng chỉ là một khuôn mẫu phổ biến trong văn bản. Không có bước nào trong quy trình tạo văn bản đối chiếu câu trả lời với thế giới, nên việc ấy thuộc về người đọc.
A3. Hạ nhiệt độ về gần 0 có làm câu trả lời đúng hơn không?
Lời giải
Không. Theo Mệnh đề 6, nhiệt độ gần 0 làm mô hình gần như luôn chọn token có điểm cao nhất. Điều đó làm câu trả lời ổn định hơn, ít lan man hơn, nhưng nếu token có điểm cao nhất là sai thì mô hình sai một cách nhất quán. Nhiệt độ thay đổi cách chọn từ một phân phối, không thay đổi việc phân phối ấy có phản ánh sự thật hay không.
A4. Vì sao phải đánh giá mô hình trên dữ liệu mà nó chưa từng dùng để học?
Lời giải
Vì mô hình đủ linh hoạt có thể khớp hoàn hảo dữ liệu đã học, kể cả phần nhiễu ngẫu nhiên (Ví dụ 7), nên mất mát trên dữ liệu ấy đánh giá quá lạc quan. Trên dữ liệu mới, độc lập với quá trình học, trung bình sai số là một ước lượng của sai số thật, và theo luật số lớn ước lượng ấy càng tin cậy khi có càng nhiều ví dụ kiểm tra.
B. Tính toán
B1. Tính softmax của \((0; \ln 2; \ln 3)\) và của \((5; 5; 5)\).
Lời giải
\(e^0 : e^{\ln 2} : e^{\ln 3} = 1 : 2 : 3\), nên softmax là \(\left(\frac16; \frac13; \frac12\right)\). Với \((5; 5; 5)\), mọi số mũ bằng nhau nên softmax là \(\left(\frac13; \frac13; \frac13\right)\); theo Mệnh đề 3, nó bằng softmax của \((0; 0; 0)\).
B2. Tính softmax của \((1; 0)\) ở nhiệt độ 1, \(0{,}1\) và 10.
Lời giải
Ở nhiệt độ 1: \(\frac{e}{e + 1} \approx 0{,}731\) và \(\approx 0{,}269\). Ở nhiệt độ \(0{,}1\), điểm thành \((10; 0)\): \(\frac{e^{10}}{e^{10} + 1} \approx 0{,}99995\), gần như chắc chắn chọn token 1. Ở nhiệt độ 10, điểm thành \((0{,}1; 0)\): \(\frac{e^{0{,}1}}{e^{0{,}1} + 1} \approx 0{,}525\), gần như chia đều, đúng như Mệnh đề 6.
B3. Một mô hình gán cho token đúng các xác suất \(0{,}8\), \(0{,}5\) và \(0{,}1\) trên ba ví dụ. Tính entropy chéo trung bình.
Lời giải
\(-\ln 0{,}8 \approx 0{,}223\), \(-\ln 0{,}5 \approx 0{,}693\), \(-\ln 0{,}1 \approx 2{,}303\). Trung bình \(\approx \frac{0{,}223 + 0{,}693 + 2{,}303}{3} \approx 1{,}073\). Ví dụ thứ ba, nơi mô hình rất ngạc nhiên, đóng góp nhiều nhất.
B4. Với điểm số \((2; 1; 0)\) và token đúng là token 1, tính gradient của entropy chéo theo điểm số. Làm một bước hạ gradient trên điểm số với bước học 1, rồi tính lại xác suất của token đúng.
Lời giải
Theo Mệnh đề 5, gradient là \(p - y \approx (0{,}665 - 1; 0{,}245; 0{,}090) = (-0{,}335; 0{,}245; 0{,}090)\). Điểm mới \(\approx (2{,}335; 0{,}755; -0{,}090)\). Xác suất mới của token 1 là \(\frac{e^{2{,}335}}{e^{2{,}335} + e^{0{,}755} + e^{-0{,}090}} \approx \frac{10{,}33}{10{,}33 + 2{,}13 + 0{,}91} \approx 0{,}772\), tăng từ \(0{,}665\).
B5. Với ba vector từ giả định vua \((1; 2; 3)\), hoàng hậu \((1; 3; 2)\) và táo \((3; 0; 1)\), tính độ tương đồng côsin của vua với hoàng hậu và của vua với táo.
Lời giải
Vua và hoàng hậu: \(\frac{1 + 6 + 6}{\sqrt{14}\sqrt{14}} = \frac{13}{14} \approx 0{,}929\). Vua và táo: \(\frac{3 + 0 + 3}{\sqrt{14}\sqrt{10}} = \frac{6}{\sqrt{140}} \approx 0{,}507\). Theo các vector giả định này, "vua" gần "hoàng hậu" hơn nhiều so với "táo".
B6. Với dữ liệu (giả định) \((1; 1)\), \((2; 3)\), \((3; 2)\) và mô hình \(y \approx wx\), viết mất mát trung bình bình phương, tìm \(w\) tốt nhất, và làm một bước hạ gradient từ \(w = 0\) với bước học \(0{,}05\).
Lời giải
\(L(w) = \frac13\big((w - 1)^2 + (2w - 3)^2 + (3w - 2)^2\big)\) và \(L'(w) = \frac23\big((w - 1) + 2(2w - 3) + 3(3w - 2)\big) = \frac23(14w - 13)\). Tốt nhất là \(w^* = \frac{13}{14} \approx 0{,}929\). Từ \(w = 0\): \(L'(0) = -\frac{26}{3}\), nên \(w_1 = 0{,}05 \cdot \frac{26}{3} = \frac{13}{30} \approx 0{,}433\).
B7. Làm lại Ví dụ 6 với \(x = 1\), \(y = 2\), \(w_1 = 1\), \(w_2 = 1\) và bước học \(0{,}1\).
Lời giải
Chiều thuận: \(z = 1\), \(h = 1\), \(\hat y = 1\), \(L = 1\). Chiều ngược: \(\frac{\partial L}{\partial \hat y} = 2(1 - 2) = -2\), \(\frac{\partial L}{\partial w_2} = -2 \cdot 1 = -2\), \(\frac{\partial L}{\partial w_1} = -2 \cdot w_2 \cdot 1 \cdot x = -2\). Bước mới: \(w_1 = w_2 = 1{,}2\), nên \(\hat y = 1{,}44\) và \(L = 0{,}56^2 = 0{,}3136\).
B8. Với sáu điểm của Ví dụ 7, kiểm tra rằng đường thẳng \(y = a + bx\) với \(b = \frac{S_{xy}}{S_{xx}}\) và \(a = \bar y - b\bar x\) cho dự đoán \(7{,}0\) tại \(x = 6\).
Lời giải
\(\bar x = 2{,}5\), \(\bar y = \frac{21{,}3}{6} = 3{,}55\), \(S_{xx} = 17{,}5\), \(S_{xy} = 17{,}25\), nên \(b = \frac{17{,}25}{17{,}5} \approx 0{,}986\) và \(a = 3{,}55 - 2{,}5b \approx 1{,}086\). Tại \(x = 6\): \(a + 6b = 3{,}55 + 3{,}5b = 3{,}55 + 3{,}45 = 7{,}0\).
B9. Tính softmax của \((1000; 999; 998)\).
Lời giải
Tính trực tiếp \(e^{1000}\) làm tràn số trên máy tính. Theo Mệnh đề 3, trừ 1000 khỏi mọi điểm: softmax của \((0; -1; -2)\), bằng softmax của \((2; 1; 0)\) (lại trừ \(-2\)), tức \(\approx (0{,}665; 0{,}245; 0{,}090)\) như Ví dụ 1.
C. Phản ví dụ và chứng minh
C1. Chứng minh rằng với mọi điểm số, xác suất softmax của token có điểm lớn nhất không nhỏ hơn \(\frac1n\), và bằng \(\frac1n\) khi và chỉ khi mọi điểm bằng nhau.
Lời giải
Gọi \(z_m\) là điểm lớn nhất. Theo Mệnh đề 2, \(p_m \geq p_i\) với mọi \(i\), nên \(n\,p_m \geq p_1 + \dots + p_n = 1\), tức \(p_m \geq \frac1n\). Dấu bằng xảy ra khi và chỉ khi mọi \(p_i = p_m\), tức mọi \(z_i = z_m\). \(\square\)
C2. Trong một kho văn bản, sau một ngữ cảnh cố định, từ "mưa" xuất hiện với tỉ lệ \(a\) và từ "nắng" với tỉ lệ \(1 - a\). Một mô hình gán xác suất \(p\) cho "mưa" và \(1 - p\) cho "nắng". Chứng minh rằng entropy chéo trung bình \(-a\ln p - (1 - a)\ln(1 - p)\) nhỏ nhất khi \(p = a\).
Lời giải
Gọi \(g(p) = -a\ln p - (1 - a)\ln(1 - p)\) trên \((0; 1)\). Ta có \(g'(p) = -\frac{a}{p} + \frac{1 - a}{1 - p}\), bằng 0 khi \((1 - a)p = a(1 - p)\), tức \(p = a\), và \(g''(p) = \frac{a}{p^2} + \frac{1 - a}{(1 - p)^2} > 0\), nên \(g\) lồi và \(p = a\) là giá trị nhỏ nhất (Chương 36). \(\square\) Học bằng entropy chéo đẩy xác suất của mô hình về đúng tần suất trong dữ liệu: điều tốt khi dữ liệu phản ánh đúng thế giới, và là thiên lệch khi dữ liệu thì không.
C3. Bác bỏ: "Một mô hình có mất mát bằng 0 trên dữ liệu huấn luyện là một mô hình tốt."
Lời giải
Đa thức bậc 5 ở Ví dụ 7 đi qua đúng cả sáu điểm, nên mất mát trên dữ liệu đã học bằng 0, nhưng nó đoán \(-2{,}4\) tại \(x = 6\), trái hẳn xu hướng của dữ liệu. Tổng quát, với \(n\) điểm có hoành độ khác nhau, luôn có một đa thức bậc không quá \(n - 1\) đi qua mọi điểm, bất kể dữ liệu có quy luật gì. Mất mát bằng 0 có thể chỉ nói rằng mô hình có đủ tham số để học thuộc, không nói rằng nó đã hiểu.
Câu hỏi để ngỏ
Máy móc giỏi tìm mẫu hình; con người vẫn phải hỏi: mẫu hình này có buộc phải đúng không? Câu hỏi để ngỏ cuối cùng dành cho bạn đọc: trong công việc và cuộc sống của bạn, cấu trúc nào vẫn chưa có tên, và bạn sẽ gỡ nó ra thế nào?
Nếu muốn đi tiếp, vài hướng mở ra từ chính những chương của sách:
- Đại số tuyến tính sâu hơn: không gian vector trừu tượng, phân tích giá trị kỳ dị, và vì sao nó đứng sau việc nén ảnh và các trục chính của dữ liệu.
- Giải tích nhiều biến: tích phân bội, đạo hàm của hàm nhiều biến có giá trị vector, và phương trình vi phân nhiều chiều.
- Xác suất và thống kê suy luận: ước lượng, khoảng tin cậy, kiểm định, và suy luận Bayes với những mô hình nhiều tham số.
- Tối ưu: tối ưu lồi, đối ngẫu, và các thuật toán cho quy hoạch tuyến tính.
- Lý thuyết thông tin: entropy, mã hóa và giới hạn của việc nén dữ liệu, nơi độ ngạc nhiên \(-\ln p\) trở thành một đơn vị đo.
- Toán rời rạc và chứng minh: lý thuyết số, tổ hợp, đồ thị, và logic.
- Học máy: từ hồi quy và phân loại tới mạng nơ-ron, với con mắt của người đã hiểu các công cụ bên trong.
Dù đi hướng nào, cách đọc vẫn như từ chương đầu: tìm cái bị ép phải xuất hiện, tách nó khỏi những quy ước đặt ra cho tiện, thử bằng tay, tìm ranh giới, rồi mới viết lại cho chặt chẽ.